شباهت کسینوسی
| یادگیری ماشین و دادهکاوی |
|---|
 |
در حوزه تحلیل داده، شباهت کسینوسی (به انگلیسی: cosine similarity) یک معیار شباهت میان دو بردار ناصفر است که در یک فضای ضرب داخلی تعریف میشود. شباهت کسینوسی برابر با کسینوس زاویه بین دو بردار است. بهعبارت دیگر، برابر است با ضرب داخلی دو بردار تقسیم بر حاصلضرب طولهای آنها. از اینرو، شباهت کسینوسی به اندازه بردارها وابسته نیست و تنها به زاویه میان آنها بستگی دارد. مقدار شباهت کسینوسی همواره در بازه قرار دارد. برای نمونه، دو بردار متناسب و همراستا دارای شباهت کسینوسی هستند، دو بردار متعامد شباهتی برابر با دارند، و دو بردار مخالف دارای شباهت هستند. در برخی زمینهها، مقادیر مؤلفههای بردارها نمیتوانند منفی باشند؛ در این حالت، شباهت کسینوسی به بازه محدود میشود.


برای مثال، در بازیابی اطلاعات و متنکاوی، به هر واژه یک مختصات متفاوت اختصاص داده میشود و هر سند نیز به نوبه خود با برداری از تعداد دفعات وقوع هر واژه در آن سند نمایش داده میشود. در این حالت، شباهت کسینوسی معیاری مفید برای سنجش میزان شباهت دو سند از نظر موضوعی فراهم میکند و این کار را مستقل از طول اسناد انجام میدهد.[۱]
در حوزه دادهکاوی از این روش برای اندازهگیری انسجام درون خوشهها استفاده میشود.[۲]
یکی از مزایای شباهت کسینوسی، پیچیدگی ناچیز محاسباتی آن، بهویژه برای بردارهای خلوت است. زیرا تنها مختصات ناصفر نیاز به بررسی دارند.
نامهای دیگر شباهت کسینوسی شامل شباهت اورکینی[الف] و ضریب تطابق تاکر[ب] هستند. شباهت اوتسوکا–اوچیای[پ]، که در ادامه آمده است، در واقع همان شباهت کسینوسی اعمالشده بر دادههای دودویی است.[۳]
تعریف
کسینوس زاویه بین دو بردار ناصفر را میتوان با استفاده از فرمول ضرب داخلی اقلیدسی بدست آورد:
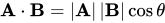
اگر دو بردار n-بعدی از ویژگیها، یعنی و ، داشته باشیم، شباهت کسینوسی، cos(θ)، با استفاده از ضرب داخلی و بزرگی به صورت زیر نمایش داده میشود:


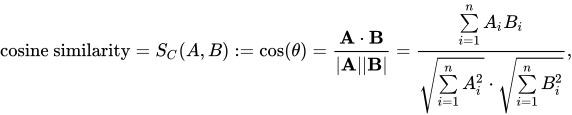
که در آن و بهترتیب مؤلفه -اُم از بردارهای و هستند.


شباهت بدستآمده در بازهای از (بهمعنای دقیقاً مخالف بودن) تا (بهمعنای دقیقاً همراستا بودن) تغییر میکند؛ مقدار 0 نشاندهنده تعامد یا ناهمبستهسازی است، و مقادیر بین این دو حد نشان دهنده درجات میانی شباهت یا عدم شباهت هستند.
در کاربرد بررسی تطابق متن، بردارهای ویژگی A و B معمولاً بردارهای فراوانی واژه اسناد هستند. شباهت کسینوسی را میتوان روشی برای نرمالسازی طول اسناد هنگام مقایسه در نظر گرفت. در کاربرد بازیابی اطلاعات، شباهت کسینوسی دو سند در بازه قرار میگیرد، زیرا فراوانی واژهها نمیتوانند منفی باشند. این موضوع هنگام استفاده از وزندهی TF-IDF نیز برقرار است. زاویه بین دو بردار فراوانی واژه نمیتواند بیش از ۹۰ درجه باشد.

اگر بردارهای ویژگی با کمکردن میانگین بردار نرمالسازی شوند (برای نمونه )، این معیار شباهت کسینوسی مرکزشده نامیده میشود و معادل ضریب همبستگی پیرسون است. برای نمونهای از مرکزسازی:


فاصله کسینوسی
اگر فاصله میان دو بردار با طول واحد، به صورت طول تفاضل برداری آنها تعریف شود، با نگاه ریاضیاتی خواهیم داشت:با این حال، فاصله کسینوسی[۴] اغلب بدون ریشه دوم یا ضریب ۲ تعریف میشود:

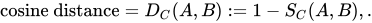
توجه شود که به دلیل متناسب بودن با مربع فاصله اقلیدسی، فاصله کسینوسی یک متریک فاصله واقعی نیست. زیرا خاصیت نابرابری مثلثی، یا به صورت رسمیتر، نابرابری کوشی–شوارتز، را ارضا نمیکند و اصل هممکانی را نقض میکند. برای ترمیم خاصیت نابرابری مثلثی در حالی که ترتیب مقایسهها حفظ شود، میتوان آن را به فاصله اقلیدسی یا فاصله زاویهای θ = arccos(SC(A, B)) تبدیل کرد. همچنین، نابرابری مثلثیای که برای فاصلههای زاویهای برقرار است میتواند مستقیماً برحسب کسینوسها بیان شود؛ برای این موضوع، بخش پایین را ببینید.

فاصله و شباهت زاویهای
زاویه نرمالشده میان هر دو بردار و ، که با عنوان فاصله زاویهای[ت] نیز شناخته میشود، یک متریک فاصله رسمی است و میتوان آن را از روی شباهت کسینوسی محاسبه کرد.[۵] مکمل این متریک فاصله زاویهای را میتوان برای تعریف تابع شباهت زاویهای[ث] به کار برد که در بازه ۰ تا ۱ (شامل دو کران) محدود است.


در حالتی که مؤلفههای بردار میتوانند مثبت یا منفی باشند:


یا، اگر مؤلفههای بردار همواره مثبت باشند:


متأسفانه، محاسبه تابع کسینوس معکوس (arccos) کند است و همین موضوع باعث میشود استفاده از فاصله زاویهای از نظر محاسباتی پرهزینهتر از استفاده از فاصله کسینوسی متداولتر (اما غیرمتریک) که پیشتر معرفی شد، باشد.
فاصله اقلیدسی نرمالشده با L2
یک تقریب مؤثر دیگر برای فاصله کسینوسی را میتوان با نرمالسازی بردارها و سپس بهکارگیری فاصله اقلیدسی معمولی بهدست آورد.[ج] در این روش، ابتدا هر مؤلفه در هر بردار، تقسیم بر بزرگی آن بردار (نُرم) میشود و در نتیجه برداری با طول واحد حاصل میگردد. سپس فاصله اقلیدسی میان نقاط انتهایی هر دو بردار، یک متریک صحیح را تشکیل میدهد که برای هر مقایسه بردارها، همان ترتیب فاصلهای فاصله کسینوسی را میدهد (این رابطه یک تبدیل یکنوا از فاصله اقلیدسی است. برای جزئیات بیشتر بخش پایین را ببینید) و افزون بر این، از عملیات مثلثاتی بالقوه پرهزینهای که برای بهدستآوردن یک متریک دقیق لازم است، اجتناب میکند.

پس از انجام نرمالسازی، فضای برداری بدستآمده را میتوان با طیف کامل روشهایی که برای هر فضای اقلیدسی در دسترس هستند، بهویژه روشهای استاندارد کاهش ابعاد، به کار گرفت. این نوع فاصله نرمالشده در بسیاری از الگوریتمهای یادگیری عمیق به طور گسترده مورد استفاده قرار میگیرد.
ضریب اوتسوکا–اوچیای
در زیستشناسی، مفهوم مشابهی با نام ضریب اوتسوکا–اوچیای وجود دارد که به افتخار یانوسوکه اوتسوکا [۶] (ژاپنی: 大塚 弥之助)[۷] و آکیرا اوچیای (ژاپنی: 落合 明)[۸] نامگذاری شده است. این ضریب با نامهای ضریب اوچیای–بارکمن[چ][۹] یا صرفاً ضریب اوچیای نیز شناخته میشود.[۱۰] این ضریب را میتوان به صورت زیر نمایش داد:
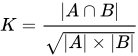
در اینجا، و مجموعه هستند و تعداد عناصر موجود در را نشان میدهد. اگر مجموعهها به صورت بردارهای بیتی نمایش داده شوند، ضریب اوتسوکا–اوچیای معادل شباهت کسینوسی خواهد بود. این ضریب با نمرهای که توسط گادفری تامسون معرفی شده است نیز یکسان است.[۱۱]

در یک کتاب نسبتاً جدید،[۱۲] این ضریب به طور موقت و نادرست به پژوهشگر ژاپنی دیگری با نام خانوادگی اوتسوکا نسبت داده شده است. این سردرگمی از آنجا ناشی میشود که در سال ۱۹۵۷، آکیرا اوچیای این ضریب را تنها به «اوتسوکا» (بدون ذکر نام کوچک) نسبت میدهد[۸] و در این کار به مقالهای از ایکوسو هامای (ژاپنی: 浜井 生三)[۱۳] استناد میکند. مقالهای که به نوبه خود به مقاله اصلی سال ۱۹۳۶ یانوسوکه اوتسوکا ارجاع میدهد.[۷]
ویژگیها
مهمترین ویژگی شباهت کسینوسی این است که مقایسهای نسبی، نه مطلق، از ابعاد منفرد بردار ارائه میدهد. برای هر ثابت مثبت و بردار ، دو بردار و بیشترین شباهت ممکن را دارند. ازاینرو، این معیار بیش از همه برای دادههایی مناسب است که در آنها فراوانی نسبت به مقادیر مطلق اهمیت بیشتری دارد؛ بهویژه فراوانی واژهها در اسناد.


با این حال، معیارهای جدیدتری که ریشه در نظریه اطلاعات دارند، مانند واگرایی جنسن–شانون، SED و واگرایی مثلثی، نشان دادهاند که دستکم در برخی زمینهها، معناشناسی بهتری ارائه میدهند.[۱۴]
شباهت کسینوسی با فاصله اقلیدسی به صورت زیر مرتبط است. فاصله اقلیدسی را با نماد متداول نشان میدهیم و توجه میکنیم که (همانی قطبیسازی):


این رابطه با بسط چندجملهای بهدست میآید. هنگامی که A و B به طول واحد نرمالسازی شوند، رابطه برقرا خواهد بود و بنابراین عبارت بالا برابر میشود با:
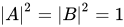

به طور خلاصه، فاصله کسینوسی را میتوان برحسب فاصله اقلیدسی به صورت زیر بیان کرد:
- .
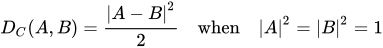
فاصله اقلیدسی در این حالت «فاصله وتر»[ح] نامیده میشود (زیرا طول وتر روی دایره واحد است) و همان فاصله اقلیدسی میان بردارهایی است که بهگونهای نرمالسازی شدهاند که مجموع مربعات مؤلفههای آنها برابر با یک باشد.
توزیع صفر[خ]: برای دادههایی که میتوانند هم منفی و هم مثبت باشند، توزیع صفر شباهت کسینوسی برابر با توزیع ضرب داخلی دو بردار واحد تصادفی و مستقل است. این توزیع دارای میانگین صفر و واریانس (که در آن تعداد ابعاد است) میباشد. با وجود آن که این توزیع میان −1 و +1 کراندار است، هرچه بزرگتر شود، این توزیع به طور فزایندهای با توزیع نرمال تقریب زده میشود.[۱۵][۱۶] برای انواع دیگر دادهها، مانند جریانهای بیتی که تنها مقادیر ۰ یا ۱ را میپذیرند، توزیع صفر شکل متفاوتی دارد و ممکن است دارای میانگین ناصفر باشد.[۱۷]


نابرابری مثلثی برای شباهت کسینوسی
نابرابری مثلثی معمولی برای زاویهها (یعنی طول کمانها روی یک ابرکره واحد) به ما میگوید که:
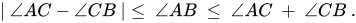
از آنجا که تابع کسینوس با افزایش زاویه در بازه [0, ] رادیان کاهش مییابد، هنگام گرفتن کسینوس از هر یک از این مقادیر، جهت این نابرابریها معکوس میشود:


با استفاده از فرمولهای جمع و تفریق کسینوس، این دو نابرابری را میتوان برحسب کسینوسهای اولیه به صورت زیر نوشت:


این شکل از نابرابری مثلثی را میتوان برای کرانبندی کمینه و بیشینه شباهت دو شیء A و B به کار برد، مشروط بر آن که شباهت هر یک از آنها با یک شیء مرجع C از پیش معلوم باشد. از این ویژگی، برای مثال، در نمایهسازی دادههای متریک استفاده میشود و همچنین برای شتاببخشیدن به خوشهبندی کی-میانگین نیز به کار رفته است.[۱۸] این کاربرد دقیقاً به همان شیوهای است که نابرابری مثلثی اقلیدسی برای شتاببخشی به الگوریتم کی-میانگین معمولی استفاده شده است.
معیار کسینوسی نرم
کسینوس نرم [د]یا («شباهت نرم») میان دو بردار، شباهت میان جفتهای ویژگی را نیز در نظر میگیرد.[۱۹] شباهت کسینوسی سنتی، ویژگیهای مدل فضای برداری را مستقل یا کاملاً متفاوت از یکدیگر در نظر میگیرد، در حالی که معیار کسینوسی نرم پیشنهاد میکند شباهت میان ویژگیها در VSM نیز لحاظ شود؛ امری که به تعمیم مفهوم کسینوس (و کسینوس نرم) و همچنین ایده شباهت (نرم) کمک میکند.
برای نمونه، در حوزه پردازش زبانهای طبیعی (کوتهنوشت: NLP)، شباهت میان ویژگیها امری بدیهی است. ویژگیهایی مانند واژهها، ان-گرامها، یا ان-گرامهای نحوی[۲۰] میتوانند بسیار شبیه به یکدیگر باشند، هرچند که از نظر صوری به عنوان ویژگیهای متفاوت در VSM در نظر گرفته میشوند. برای مثال، واژههای انگلیسی «play» و «game» دو واژه متفاوت هستند و بنابراین به نقاط متفاوتی در VSM نگاشته میشوند، اما از نظر معنایی با یکدیگر مرتبطاند. در مورد ان-گرامها یا ان-گرامهای نحوی، میتوان از فاصله لوناشتاین استفاده کرد (در واقع فاصله لوناشتاین برای واژهها نیز قابل اعمال است).
برای محاسبه کسینوس نرم، از ماتریس s استفاده میشود که میزان شباهت میان ویژگیها را نشان میدهد. این ماتریس میتواند با استفاده از فاصله لوناشتاین، شباهت وردنت، یا سایر معیارهای شباهت محاسبه شود. در ادامه، کافی است این ماتریس در محاسبات ضرب شود.
اگر دو بردار و با بعد N داده شده باشند، شباهت کسینوسی نرم به صورت زیر محاسبه میشود:


اگر هیچ شباهتی میان ویژگیها وجود نداشته باشد (sii = 1 و sij = 0 برای i ≠ j)، معادله فوق معادل فرمول متداول شباهت کسینوسی خواهد بود.
پیچیدگی زمانی این معیار از مرتبه درجه دوم است، که آن را برای مسائل دنیای واقعی قابل استفاده میسازد. توجه داشته باشید که این پیچیدگی میتواند به کمتر از درجه دوم نیز کاهش یابد.[۲۱] یک پیادهسازی کارآمد از چنین شباهت کسینوسی نرمی در کتابخانه متنباز جنسیم گنجانده شده است.
جستارهای وابسته
- ضریب سورنسن–دایس
- فاصله همینگ
- همبستگی و وابستگی
- اندیس ژاکار
- SimRank
- بازیابی اطلاعات
یادداشتها
منابع
- ↑ Singhal, Amit (2001). "Modern Information Retrieval: A Brief Overview". Bulletin of the IEEE Computer Society Technical Committee on Data Engineering 24 (4): 35–43.
- ↑ P.-N. Tan, M. Steinbach & V. Kumar, Introduction to Data Mining, Addison-Wesley (2005), شابک ۰−۳۲۱−۳۲۱۳۶−۷, chapter 8; page 500.
- ↑ "cosine_similarity: Function for calculating the cosine similarity". rDrr.io. Retrieved 18 November 2024.
- ↑ Wolfram Research (2007). "CosineDistance – Wolfram Language & System Documentation Center". wolfram.com.
- ↑ "COSINE DISTANCE, COSINE SIMILARITY, ANGULAR COSINE DISTANCE, ANGULAR COSINE SIMILARITY". www.itl.nist.gov. Retrieved 2020-07-11.
- ↑ Omori, Masae (2004). "Geological idea of Yanosuke Otuka, who built the foundation of neotectonics (geoscientist)". Earth Science. 58 (4): 256–259. doi:10.15080/agcjchikyukagaku.58.4_256.
- 1 2 Otsuka, Yanosuke (1936). "The faunal character of the Japanese Pleistocene marine Mollusca, as evidence of the climate having become colder during the Pleistocene in Japan". Bulletin of the Biogeographical Society of Japan. 6 (16): 165–170.
- 1 2 Ochiai, Akira (1957). "Zoogeographical studies on the soleoid fishes found in Japan and its neighhouring regions-II". Bulletin of the Japanese Society of Scientific Fisheries. 22 (9): 526–530. doi:10.2331/suisan.22.526.
- ↑ Barkman, Jan J. (1958). Phytosociology and Ecology of Cryptogamic Epiphytes: Including a Taxonomic Survey and Description of Their Vegetation Units in Europe. Assen: Van Gorcum.
- ↑ Romesburg, H. Charles (1984). Cluster Analysis for Researchers. Belmont, California: Lifetime Learning Publications. p. 149.
- ↑ Thomson, Godfrey (1916). "A hierarchy without a general factor" (PDF). British Journal of Psychology. 8: 271–281.
- ↑ Howarth, Richard J. (2017). Dictionary of Mathematical Geosciences: With Historical Notes. Cham: Springer. p. 421. Bibcode:2017dmgh.book.....H. doi:10.1007/978-3-319-57315-1. ISBN 978-3-319-57314-4. S2CID 67081034.
[…] attributed by him to “Otsuka” [?A. Otsuka of the Dept. of Fisheries, Tohoku University].
- ↑ Hamai, Ikuso (1955). "Stratification of community by means of "community coefficient" (continued)". Japanese Journal of Ecology. 5 (1): 41–45. doi:10.18960/seitai.5.1_41.
- ↑ Connor, Richard (2016). A Tale of Four Metrics. Similarity Search and Applications. Tokyo: Springer. doi:10.1007/978-3-319-46759-7_16.
- ↑ Spruill, Marcus C. (2007). "Asymptotic distribution of coordinates on high dimensional spheres". Electronic Communications in Probability. 12: 234–247. doi:10.1214/ECP.v12-1294.
- ↑ "Distribution of dot products between two random unit vectors in RD". CrossValidated.
- ↑ Graham L. Giller (2012). "The Statistical Properties of Random Bitstreams and the Sampling Distribution of Cosine Similarity". Giller Investments Research Notes (20121024/1). doi:10.2139/ssrn.2167044. S2CID 123332455.
- ↑ Schubert, Erich; Lang, Andreas; Feher, Gloria (2021). "Accelerating Spherical k-Means". In Reyes, Nora; Connor, Richard; Kriege, Nils; Kazempour, Daniyal; Bartolini, Ilaria; Schubert, Erich; Chen, Jian-Jia (eds.). Similarity Search and Applications. Lecture Notes in Computer Science (به انگلیسی). Vol. 13058. Cham: Springer International Publishing. pp. 217–231. arXiv:2107.04074. doi:10.1007/978-3-030-89657-7_17. ISBN 978-3-030-89657-7. S2CID 235790358.
- ↑ Sidorov, Grigori; Gelbukh, Alexander; Gómez-Adorno, Helena; Pinto, David (29 September 2014). "Soft Similarity and Soft Cosine Measure: Similarity of Features in Vector Space Model". Computación y Sistemas. 18 (3): 491–504. doi:10.13053/CyS-18-3-2043. Retrieved 7 October 2014.
- ↑ Sidorov, Grigori; Velasquez, Francisco; Stamatatos, Efstathios; Gelbukh, Alexander; Chanona-Hernández, Liliana (2013). Advances in Computational Intelligence. Lecture Notes in Computer Science. Vol. 7630. LNAI 7630. pp. 1–11. doi:10.1007/978-3-642-37798-3_1. ISBN 978-3-642-37798-3.
- ↑ Novotný, Vít (2018). Implementation Notes for the Soft Cosine Measure. The 27th ACM International Conference on Information and Knowledge Management. Torun, Italy: Association for Computing Machinery. pp. 1639–1642. arXiv:1808.09407. doi:10.1145/3269206.3269317. ISBN 978-1-4503-6014-2.